Node.js 实现断点下载器

本文从 HTTP/1.1 Range 分片传输协议(RFC 7233)出发,深入剖析断点续传的协商与一致性校验机制,并基于现代 Node.js 原生模块实现一套支持状态码自适应降级、原子持久化与优雅中断的工业级下载器。


在编写命令行下载工具(如我早期开发的 eva)或处理大文件拉取业务时,网络波动导致的连接中断、弱网环境超时以及意外关闭终端是无法避免的现实问题。

如果一个 2GB 的资源在下载到 99% 时断网,缺乏断点续传机制的下载器就必须“从零重开”,这不仅极度损耗用户体验,更白白消耗宝贵的服务器带宽。


一、HTTP 断点续传协议核心机制 (RFC 7233)

所谓“断点续传”,本质上是客户端与服务端基于 HTTP 协议头完成的一场分片范围协商。

sequenceDiagram
    autonumber
    actor Client as 客户端 (Node.js)
    participant Server as HTTP 服务端

    Note over Client: 检查本地发现已有临时分片 file.part (大小 1024 字节)
    Client->>Server: HEAD /file.zip
    Server-->>Client: 200 OK
Accept-Ranges: bytes
Content-Length: 5242880
ETag: "w/3a8f-abc123" alt 服务端支持 Range (Accept-Ranges: bytes) Client->>Server: GET /file.zip
Range: bytes=1024-
If-Range: "w/3a8f-abc123" Server-->>Client: 206 Partial Content
Content-Range: bytes 1024-5242879/5242880
[返回剩余的二进制流数据] Note over Client: 以追加模式 (flags: 'a') 将流写入本地临时文件 else 服务端不支持 Range Server-->>Client: 200 OK
[返回完整的二进制流数据] Note over Client: 降级为全量覆盖下载 (flags: 'w') end

1. 协商三部曲:探测、范围请求与响应

  1. 预检与能力探测(Accept-Ranges):通过发送 HEAD 请求获取目标资源的基础元信息。若响应头包含 Accept-Ranges: bytes,则证明服务器支持基于字节偏移的局部读取。
  2. 请求指定字节区间(Range):客户端根据本地已下载的文件字节数(如 1024 字节),在后续 GET 请求中附带请求头:
    1
    Range: bytes=1024-
    表示“从第 1024 字节开始,请求直到文件末尾的所有数据”。
  3. 分片响应状态码(206 Partial Content):
    • 支持断点续传:服务端返回 206 Partial Content,并在响应头中通过 Content-Range 标明当前切片的起止范围与总大小(例如 Content-Range: bytes 1024-5242879/5242880);
    • 不支持断点续传:服务端会直接忽略 Range 头,返回标准的 200 OK,并从第 0 字节开始推送完整内容。客户端必须对此做好平滑降级(改为全量覆写)。

2. 避免数据污染的关键:资源一致性校验 (If-Range / ETag)

在断点续传的间隔期内,服务端的文件内容可能已经被重新发布或修改。如果客户端继续拿着旧文件的字节偏移去追加新文件的尾部,最终拼合出的必然是一个彻底损坏的乱码文件。

为了避免这种静默的数据污染,必须引入一致性校验:

  • ETag / Last-Modified:首次请求时保存资源的实体标签(ETag)或最后修改时间;
  • If-Range:续传时将 ETag 作为 If-Range 头的值带上。若资源未变,服务器返回 206 继续下载;若资源已变动,服务器会自动判定失效并直接返回 200 全量数据,此时客户端应重新创建文件并从头写入。

二、Node.js 核心机制与工程要点

在 Node.js 中构建断点下载器,核心是围绕 fs 模块与 stream 模块做流转调度:

  1. 已存在字节探测:使用 fs.promises.stat(partFilePath) 获取本地已写入的字节尺寸 stats.size,以此确定 Range 请求的起始偏移量。
  2. 文件写入模式(flags: 'a' vs flags: 'w'):
    • 收到 206 Partial Content 时:使用 fs.createWriteStream(filePath, { flags: 'a' }) 以追加模式将流接入文件尾部;
    • 收到 200 OK 时:必须切换为 { flags: 'w' }(或清空旧临时文件),防止将全量数据拼接在旧残片后面造成体积翻倍。
  3. 临时文件(.part)原子重命名机制:为了防止网络中断留下半成品文件被其他程序误当成完整文件处理,在下载期间所有数据必须写入临时文件(如 target.zip.part)。只有当流触发 finish / close 且完成大小校验后,再调用 fs.promises.rename 原子重命名为目标文件名。
  4. 流式背压与安全流管道(stream.pipeline):早期的 .pipe() 无法自动处理管道中的双向错误捕获与流销毁,容易引发内存泄漏或文件句柄挂起。现代 Node.js 推荐使用 stream.promises.pipeline 或标准 Web Streams API。
  5. 实时进度、瞬时速度与 ETA 计算:
    • 瞬时下载速率:固定采样周期(如 1000ms),统计该周期内接收的字节差值: $$\text{Speed} = \frac{\Delta \text{Bytes}}{\Delta t}$$
    • 剩余预估时间(ETA): $$\text{ETA} = \frac{\text{TotalBytes} - \text{CompletedBytes}}{\text{Speed}}$$

三、现代 Node.js 原生断点续传下载器实现

下面给出一套无第三方废弃依赖、基于现代 Node.js 内置模块(node:http / node:https、node:fs、node:events)且支持 Range 自动探测、206/200 优雅降级、实时进度/速度广播与 AbortController 中断控制 的完整实现。

1. Downloader.mjs 核心类实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
import EventEmitter from "node:events";
import fs from "node:fs";
import http from "node:http";
import https from "node:https";
import path from "node:path";
import { pipeline } from "node:stream/promises";

export class Downloader extends EventEmitter {
constructor(options = {}) {
super();
this.timeout = options.timeout || 30000;
this.abortController = null;
}

/**
* 发送 HEAD 请求探测资源元信息(支持自动跟随重定向)
*/
async probeResource(targetUrl, maxRedirects = 5) {
if (maxRedirects < 0) throw new Error("重定向次数过多");
const client = targetUrl.startsWith("https") ? https : http;

return new Promise((resolve, reject) => {
const req = client.request(targetUrl, { method: "HEAD" }, (res) => {
if (res.statusCode >= 300 && res.statusCode < 400 && res.headers.location) {
const redirectUrl = new URL(res.headers.location, targetUrl).toString();
return resolve(this.probeResource(redirectUrl, maxRedirects - 1));
}

const acceptRanges = res.headers["accept-ranges"];
const contentLength = res.headers["content-length"]
? parseInt(res.headers["content-length"], 10)
: null;
const etag = res.headers["etag"] || null;

resolve({
statusCode: res.statusCode,
supportsRange: acceptRanges === "bytes",
totalSize: contentLength,
etag
});
});

req.on("error", reject);
req.setTimeout(this.timeout, () => {
req.destroy(new Error("HEAD 请求探测超时"));
});
req.end();
});
}

/**
* 执行断点续传下载
* @param {string} url 下载地址
* @param {string} destination 目标文件本地存储路径
*/
async download(url, destination) {
const destDir = path.dirname(destination);
if (!fs.existsSync(destDir)) {
await fs.promises.mkdir(destDir, { recursive: true });
}

const partFile = `${destination}.part`;
let downloadedBytes = 0;

// 1. 检查是否存在未下载完的临时分片
if (fs.existsSync(partFile)) {
const stat = await fs.promises.stat(partFile);
downloadedBytes = stat.size;
}

// 2. 探测服务端能力
const meta = await this.probeResource(url);

// 如果本地已下载尺寸与服务端完全一致,无需再次请求
if (meta.totalSize && downloadedBytes === meta.totalSize) {
await fs.promises.rename(partFile, destination);
this.emit("complete", { destination, totalBytes: meta.totalSize });
return;
}

// 3. 构建请求头,协商 Range 与 If-Range
const headers = {};
let isResume = false;

if (meta.supportsRange && downloadedBytes > 0) {
headers["Range"] = `bytes=${downloadedBytes}-`;
if (meta.etag) headers["If-Range"] = meta.etag;
isResume = true;
}

this.abortController = new AbortController();
const client = url.startsWith("https") ? https : http;

return new Promise((resolve, reject) => {
const req = client.get(url, { headers, signal: this.abortController.signal }, async (res) => {
// 处理可能发生的重定向
if (res.statusCode >= 300 && res.statusCode < 400 && res.headers.location) {
const redirectUrl = new URL(res.headers.location, url).toString();
return resolve(this.download(redirectUrl, destination));
}

const statusCode = res.statusCode;
let writeFlag = "w";
let actualStart = 0;
let totalBytes = meta.totalSize;

if (statusCode === 206) {
// 服务端成功接受断点续传请求
writeFlag = "a";
actualStart = downloadedBytes;
const contentRange = res.headers["content-range"];
if (contentRange) {
const match = contentRange.match(/\/(\d+|\*)$/);
if (match && match[1] !== "*") {
totalBytes = parseInt(match[1], 10);
}
}
} else if (statusCode === 200) {
// 服务端不支持断点或 If-Range 校验失效,全量覆写
writeFlag = "w";
actualStart = 0;
downloadedBytes = 0;
totalBytes = res.headers["content-length"]
? parseInt(res.headers["content-length"], 10)
: null;
} else if (statusCode === 416) {
// 请求范围不合理(如临时文件已被写乱),删除重试
await fs.promises.unlink(partFile).catch(() => {});
return resolve(this.download(url, destination));
} else {
return reject(new Error(`下载失败,HTTP 状态码异常: ${statusCode}`));
}

const fileStream = fs.createWriteStream(partFile, { flags: writeFlag });
let receivedBytesSinceLastTick = 0;
let currentCompleted = actualStart;
const startTime = Date.now();

// 启动 1 秒采样的速率与进度计时器
const progressTimer = setInterval(() => {
const speed = receivedBytesSinceLastTick; // 字节/秒
receivedBytesSinceLastTick = 0;
const percent = totalBytes ? ((currentCompleted / totalBytes) * 100).toFixed(2) : null;
const eta = speed > 0 && totalBytes ? Math.ceil((totalBytes - currentCompleted) / speed) : null;

this.emit("progress", {
completed: currentCompleted,
total: totalBytes,
percent: percent ? `${percent}%` : "未知",
speedBytesPerSec: speed,
speedFormatted: `${(speed / 1024 / 1024).toFixed(2)} MB/s`,
etaSeconds: eta
});
}, 1000);

res.on("data", (chunk) => {
receivedBytesSinceLastTick += chunk.length;
currentCompleted += chunk.length;
});

try {
await pipeline(res, fileStream);
clearInterval(progressTimer);

// 4. 全部接收完毕,原子重命名为最终产物
await fs.promises.rename(partFile, destination);
this.emit("complete", {
destination,
totalBytes: currentCompleted,
elapsedTimeMs: Date.now() - startTime
});
resolve();
} catch (err) {
clearInterval(progressTimer);
if (err.name === "AbortError") {
this.emit("paused", { completed: currentCompleted });
resolve();
} else {
reject(err);
}
}
});

req.on("error", reject);
});
}

/**
* 手动中断/暂停当前下载
*/
pause() {
if (this.abortController) {
this.abortController.abort();
this.abortController = null;
}
}
}

2. 客户端调用示例与终端实时进度条

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import { Downloader } from "./Downloader.mjs";

const downloader = new Downloader();

downloader.on("progress", (p) => {
process.stdout.write(
`\r⚡ 已下载: ${(p.completed / 1024 / 1024).toFixed(2)} MB ` +
`| 进度: ${p.percent} ` +
`| 速度: ${p.speedFormatted} ` +
`| 预估剩余: ${p.etaSeconds !== null ? p.etaSeconds + "s" : "计算中..."} `
);
});

downloader.on("complete", (res) => {
console.log(`\n🎉 下载完成!文件已妥善保存至: ${res.destination},耗时: ${(res.elapsedTimeMs / 1000).toFixed(2)}s`);
});

downloader.on("paused", (p) => {
console.log(`\n⏸️ 下载已暂停,当前已固化分片: ${(p.completed / 1024 / 1024).toFixed(2)} MB`);
});

const targetUrl = "https://speed.hetzner.de/100MB.bin";
const destPath = "./downloads/100MB.bin";

console.log("🚀 开始任务...");
await downloader.download(targetUrl, destPath);

四、历史实现复盘与演进过程

在早期为 eva 编写断点下载模块时,社区流行使用基于 request 库的事件模型构建(当时设计思路如下图所示)。

当时的核心逻辑在于利用定时轮询将事件通过 EventEmitter 广播给 CLI 显示组件(如 ora 旋转框):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
// 早期基于 request 库的思路原型(已弃用,仅供演进参考)
const res = Request(opts);
const Interval = setInterval(() => {
that.emit("progress", {
completed: read,
total,
speed,
status: { down: "正在下载...", end: "完成\n" }
});
speed = 0;
}, 1000);

// 设置 Range 偏移
read && res.setHeader("Range", `bytes=${read}-`);

res.on("data", (data) => {
speed += data.length;
read += data.length;
}).on("end", () => {
clearInterval(Interval);
});

// 追加模式写入文件
res.pipe(fs.createWriteStream(dir, { flags: read ? "a" : "w" }));

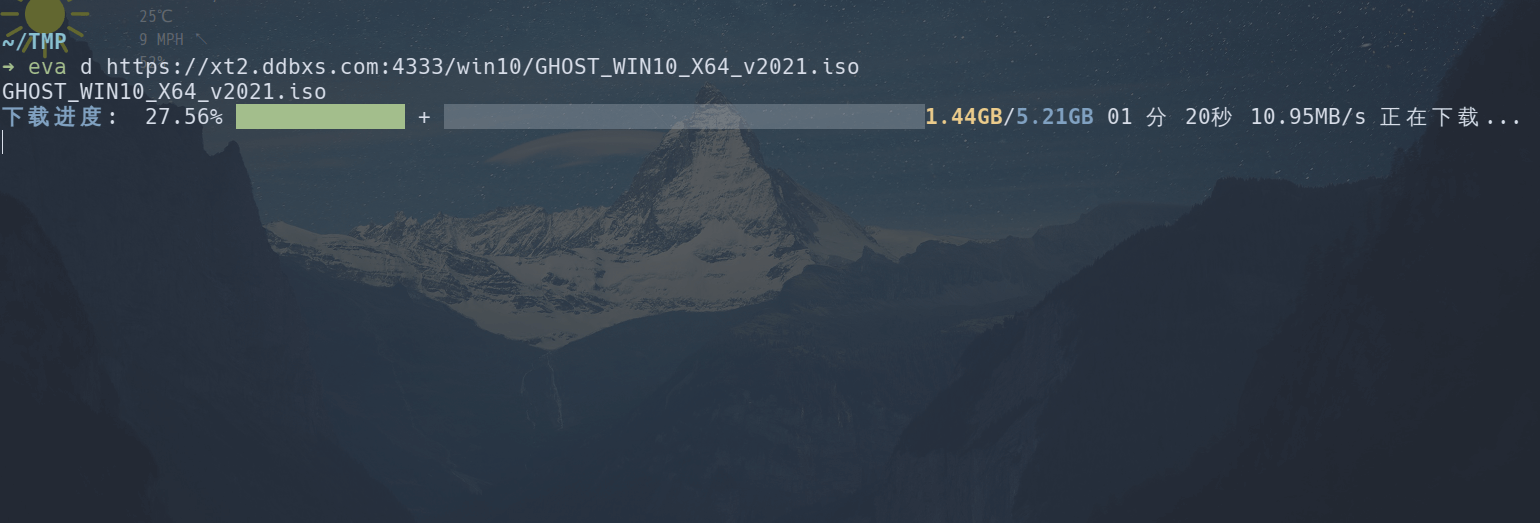
在 eva 命令行界面中的动态终端呈现效果:

eva 实际运行效果展示

历史设计的不足与现代演进反思

  1. 上游生态变迁: request 库早在 2020 年就已正式宣布弃用(Deprecated)。现代工程应当拥抱 Node.js 原生的 node:http / node:https,或通过 fetch + Web Streams 保持零外部运行时依赖。
  2. 防范数据损坏的健壮性:早期代码直接写入最终目标路径,如果下载中途被 Ctrl + C 强杀,本地留下的半截文件可能直接误导外部解析程序;现代设计必须引入 .part 临时后缀 + 原子 rename 机制。
  3. 缺少预检与状态码分支:早期假设服务端必然支持 Range,如果服务端实际上返回了 200 OK,追加模式(flags: "a")就会导致新旧两份文件堆叠在一起,文件直接报废。新版本必须严格区分 206 与 200 状态码。

五、工业级落地的边界条件与避坑要点

  1. HTTP 416 (Range Not Satisfiable) 陷阱:当本地 .part 临时文件的体积因为某种异常(例如之前的下载被服务器强制重定向或写入了 HTML 错误页)大于等于服务端的真实文件大小时,服务端会返回 HTTP 416。遇到 416 时必须主动清空本地损坏的分片,重新发起全量下载。
  2. CDN 与反向代理的压缩干扰(Gzip / Brotli):如果服务端对大文件开启了动态压缩,响应头可能缺失 Content-Length,或者返回的是压缩流的长度,导致字节偏移与实际解压后的文件脱节。在请求头中显式声明 Accept-Encoding: identity 可指示服务端不要压缩二进制文件。
  3. 多连接并行切片(Multi-threading Chunked Download):对于超大文件(如数十 GB),断点续传常与多线程并发结合:预先获取总大小,按照 10MB 分片向不同线程分配 Range: bytes=0-10485759、Range: bytes=10485760-20971519,各个分片独立下载为 .part.0、.part.1,最后通过文件流按序合并。

结语

一个健壮的断点续传器不仅是几行 HTTP 头的堆叠,更是一套包含了协议协商预检、状态码自适应降级、数据流背压控制、原子文件状态机以及优雅中断的系统化网络工程实践。


Node.js 实现断点下载器
https://bubao.github.io/posts/702b3b5b.html
作者
一念
发布于
2021年2月6日
许可协议